当前位置:


企业大模型私有化部署:数据安全与落地实践全解析
发布时间:2026-11-03 14:29 浏览次数:次 作者:
当大模型从"试用"走向"生产",企业大模型私有化部署 成为金融、政务、医疗等敏感行业绕不开的命题。与公有云 API 相比,私有化把模型与数据留在自主管控边界内,是数据安全与合规的底座。
为什么选私有化部署
通用公有模型虽便捷,却面临数据出域、合规不确定、定制受限三重约束。对高监管行业而言,私有化部署意味着训练语料、推理日志、业务结果全程不出内网,从根上消解数据泄露风险。
三类部署形态
1. 全栈私有化
从算力、框架到模型权重全部本地,适合强监管场景,自主度最高、成本也最高。
2. 专有云/托管私有
在服务商专有云区隔离部署,兼顾弹性与合规,运维负担更低。
3. 混合部署
敏感数据本地推理、通用能力走公有,平衡成本与安全。详见我们此前的大模型场景落地分析。
落地四步法
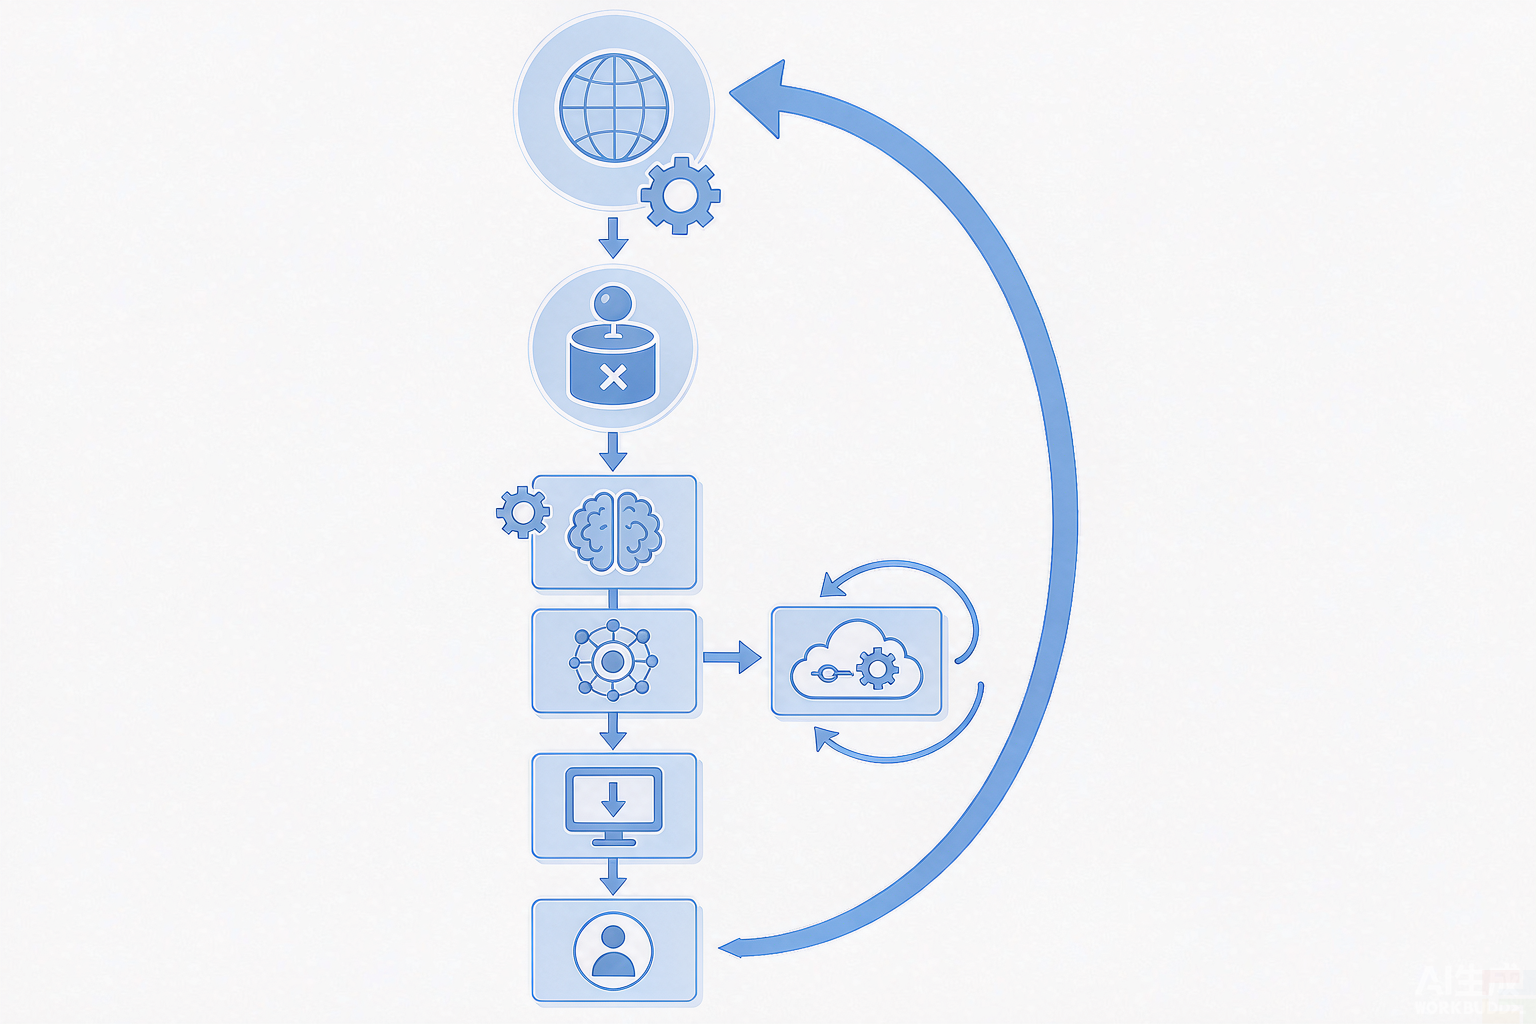
- 盘点数据:明确哪些数据可训练、哪些需脱敏;
- 选型对齐:以业务指标反推模型规模与推理时延;
- 安全加固:传输加密、访问控制、审计日志三件套;
- 持续运营:监控漂移、定期评估、灰度迭代。
结语
大模型私有化部署 不是"把模型搬回家"那么简单,而是一套涵盖数据、合规、架构的体系工程。对重视数据安全的组织,它正从"可选项"变为"必选项"。
本文为原创技术观察,观点参考公开行业资料,转载请注明出处。
 上一篇